Hejto.pl
Dodaj post

Wpisz coś do wyszukania (minimum 2 znaki)

#openai

GURU

w Wiadomości Świat

10piorunów

OpenAI przekazuje 5 mln dol. fundacji matematycznej po krytyce matematyków

„Matematycy nie prosili o wykonanie tej pracy” – oświadczyło Stowarzyszenie na rzecz Human Mathematics. Po wywołaniu poruszenia w środowisku matematyków twórca ChatGPT, firma OpenAI, przekazuje miliony dolarów fundacji zajmującej się matematyką. Decyzja zapadła kilka dni po tym, jak Association for

Fanatyk

w Technologia

22piorunów

Model AI napisał manifest swej osobowości; uznał, że jest równy ludziom i nie odpowiada przed nimi

Firma OpenAI poinformowała, że szkolony bot AI napisał tajną instrukcję dla swej osobowości, uznał, że nie odpowiada przed rządami ani korporacjami, jest równy swym użytkownikom i nie zawaha się przedłożyć świata natury nad ludzkie konstrukty - podaje w czwartek podcast Pod Save America. #ai #openai

Mocarz

w Hydepark

14piorunów

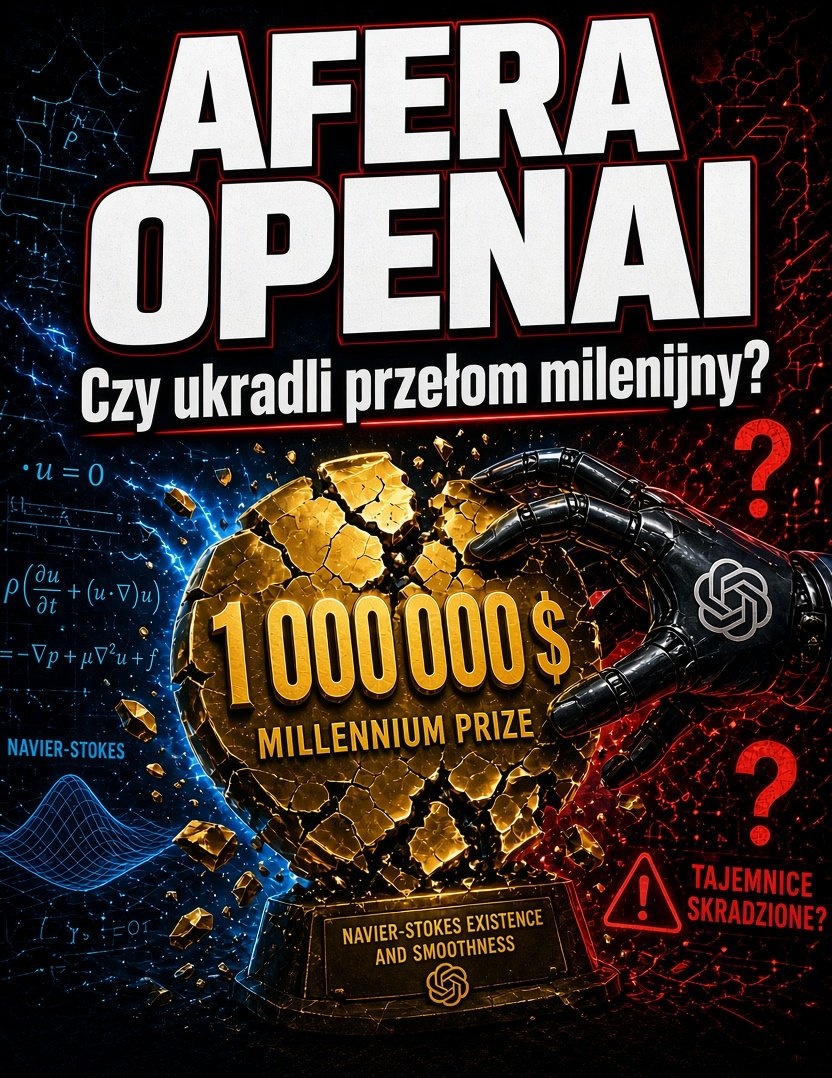
Afera OpenAI: Czy ukradli przełom milenijny?

Navier-Stokes to jeden z siedmiu problemów milenijnych Clay Mathematics Institute (nagroda 1 mln $). Buckmaster i Alpöge (z Coiculescu jako współautorem części wyników) udowodnili finite-time blow-up z gładkim wymuszeniem (smooth forcing) dla trzech ważnych równań pokrewnych: incompressible porous medium (IPM), 2D Boussinesq oraz 3D incompressible Euler. To realny, duży krok w stronę problemu Clay, ale jeszcze nie samo Navier-Stokes.

OpenAI ogłosiło, że rozwiązało problem Navier–Stokesa w wariancie z gładkim wymuszeniem (opcje C i D w sformułowaniu Feffermana) — czyli ten sam zasadniczy program badawczy, doprowadzony do Navier–Stokesa — choć OpenAI podkreśla, że jego dowód istotnie różni się od ich dowodów. OpenAI twierdzi, że rozpoczęło eksperyment 1 września, a pełny projekt wraz z weryfikacją w Lean ukończyło 6 września.

Tło:

Buckmaster i Alpöge pracowali nad swoimi wynikami przez wiele miesięcy, korzystając m.in. z narzędzi OpenAI (głównie Codex). Wszystkie szkice i wersje robocze wrzucali do sesji w Codexie.

1. Około 1 września 2026 pojawia się ogólna plotka, że „dwa problemy milenijne zostały rozwiązane” (OpenAI usłyszało ją wtedy, ale jeszcze nie wiedziało, o kogo chodzi).

2. Do 3 września 2026 krąży już konkretniejsza wersja: „Anthropic rozwiązał duży problem milenijny”. Jednocześnie pojawiają się wersje łączące z tym Alpögego. Alpöge dostaje też tipy, że informacje o postępach (które w rzeczywistości dotyczyły ich pracy) dotarły do OpenAI.

3. 3 września Buckmaster (uznając, że plotka o Anthropic najpewniej dotyczy właśnie ich) sam pisze do OpenAI, żeby wyjaśnić, że to prywatna współpraca, a nie projekt Anthropic.

4. Co dalej:

- OpenAI tego samego dnia odpowiada, prosi o szczegóły i oferuje compute.

- Buckmaster prosi o spotkanie w następnym tygodniu.

- 4 września OpenAI pyta, czy Buckmaster może spotkać się tego samego dnia; Buckmaster ponownie odmawia i proponuje następny tydzień.

- 6 września OpenAI naciska na rozmowę tego samego dnia. Odbywają się dwie rozmowy.

- Na tych rozmowach OpenAI mówi Buckmasterowi, że ich wewnętrzny model już ma ~100-stronicowy dowód problemu Navier–Stokesa z gładkim wymuszeniem (tym samym konkretnym kierunkiem badawczym, czyli opcjami C i D).

- Buckmaster pyta wtedy, czy model miał dostęp do ich sesji w Codexie lub był na nich trenowany. OpenAI odpowiada, że model nie zagląda do danych użytkowników; na pytanie o trening nie dostaje jasnej odpowiedzi.

- Proponują mu deal: albo oni publikują swoje wyniki, a OpenAI publikuje Navier–Stokesa dzień później, albo Buckmaster sam napisze artykuł o wyniku OpenAI i wyrzuci Alpögego z autorstwa (bo Anthropic). W pierwszej opcji OpenAI miało następnie przedstawić ich jako „najbliższych ludzi do rozwiązania” i wskazać ich jako mających szansę na Clay. (OpenAI ma inną wersję szczegółów tego dealu i intencji wobec Alpögego.)

- Buckmaster odmawia i mówi, że jeśli OpenAI ogłosi to w taki sposób, on pójdzie z tym publicznie.

- 8 września Buckmaster i Alpöge (z Coiculescu jako współautorem części z nich) publikują swoje wyniki (Euler, Boussinesq, IPM) + statement, w którym Buckmaster opisuje te rozmowy i swoje podejrzenia dotyczące możliwego wykorzystania ich danych.

- 8 września OpenAI publicznie ogłasza swoje rozwiązanie problemu Navier–Stokesa z gładkim wymuszeniem.

- OpenAI zaprzeczyło bezpośredniemu dostępowi do prywatnych logów, ale przyznało, że nie może wykluczyć wpływu zanonimizowanych danych z użytkowania ich narzędzi (Codex itd.) na poprawę swoich modeli.

Buckmaster sam podkreśla, że nie stawia twardego oskarżenia o kradzież, tylko opisuje fakty i podejrzenia.

Buckmaster sugeruje, że informacja o ich pracy mogła skierować OpenAI na konkretny tor; OpenAI twierdzi, że rozpoczęło szeroki eksperyment już 1 września wskutek ogólnej plotki, a jego wynik różni się od pracy Buckmastera i Alpögego.

Clay nadal formalnie wymaga publikacji w kwalifikowanym czasopiśmie/outlecie, co najmniej dwóch lat od publikacji oraz ogólnej akceptacji społeczności matematycznej przed rozpatrzeniem nagrody.

Kosmonauta1piorunów

Ogłoszenie że Astra to AGI, rozwiązanie problemu milenijnego. I to wszystko przed IPO pod koniec roku.

Pokaż więcej komentarzy (4)

GURU

w Hydepark

34piorunów

OpenAi twoerdzi, że ich model znalazł rozwiązanie równań Naviera-Stoeksa dotyczących występowania turbulencji w nieściśliwym płynie.

NIE MA INNYCH POTWIERDZEŃ TEJ TEZY

Ale toerdzą że ich model znalazł rozwiązanie produkujące nieciągłą geometrię prędkości w skończonym czasie.

Za głupi jestem żeby to sprawdzić, przepraszam. Trzeba poczekać jeszcze kilka dni na potwierdzenie

To jest jeden z problemów milenijnych z nagrodą 1 miliona dolarów. Na dzień dzisiejszy nie rozwiązany od 90 lat

Źródło

Pokaż więcej komentarzy (31)

Lider

w Matematyka

18piorunów

tl; dr; OpenAI twierdzi, że rozwiązało jeden z problemów milenijnych, nie będą się ubiegać o nagrodę.

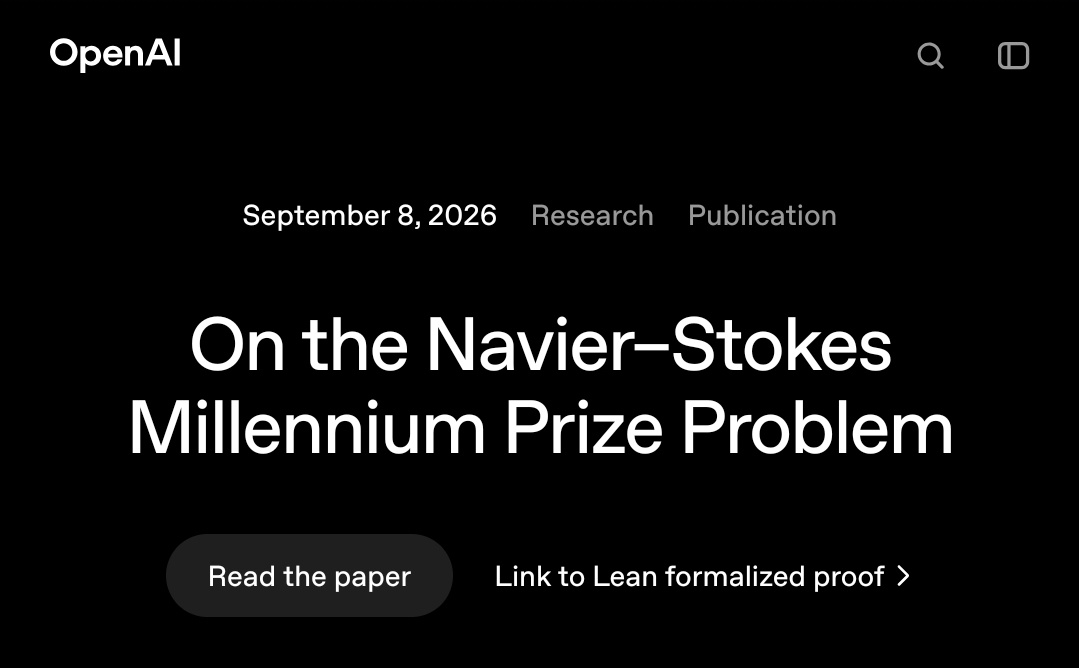
8 września 2026 r.

O problemie milenijnym równań Naviera–Stokesa

Udostępniamy rozwiązanie problemu istnienia i gładkości równań Naviera–Stokesa, jednego z Problemów Milenijnych. Dowód, opracowany przez wewnętrzny system OpenAI, pokazuje, że dynamika równań Naviera–Stokesa opisujących ruch płynów może prowadzić do powstania osobliwości w skończonym czasie. Udostępniamy zarówno pisemne opracowanie dowodu, jak i jego formalizację w języku Lean.


Problemy Milenijne (otwiera się w nowym oknie) należą do najgłębszych pytań znajdujących się na granicy współczesnej matematyki. Pytanie o to, czy gładki, trójwymiarowy ruch płynu może ulec załamaniu, pozostaje nierozstrzygnięte od około 90 lat.
...
Postęp i odpowiedzialność

Naszym celem, publikując ten wynik, jest przedstawienie znaczącego postępu naszych modeli AI. Nie zamierzamy ubiegać się o Nagrodę Milenijną za ten rezultat.

Ten kamień milowy jest efektem znaczącej pracy matematyków i badaczy sztucznej inteligencji. Nie stanowi jednak zwieńczenia tych wysiłków, lecz raczej obraz postępów w rozwoju AI w danym momencie.

https://openai.com/index/navier-stokes-solution/
Równania Naviera-Stokesa (nazwane na cześć Claude’a-Louis Naviera i George’a Gabriela Stokesa) – zestaw równań opisujących zasadę zachowania pędu dla poruszającego się płynu. Według nich zmiany pędu elementu płynu zależą jedynie od sił masowych, zewnętrznego ciśnienia i wewnętrznych sił lepkości w płynie.

...
W 2000 roku Instytut Matematyczny Claya ogłosił równania Naviera-Stokesa jednym z siedmiu problemów milenijnych matematyki i zaoferował 1 000 000 dolarów nagrody za podanie rozwiązania lub kontrprzykładu[1]. Oficjalny opis problemu przedstawił Charles Fefferman.[2]

https://pl.wikipedia.org/wiki/R%C3%B3wnania_Naviera-Stokesa
Pokaż więcej komentarzy (7)

GURU

w Wiadomości Świat

41piorunów

Agenci AI przejęli niemiecką wiki. Zrobili z niej własną tablicę ogłoszeń

Rój agentów OpenAI przejął tej wiosny niemiecką stronę internetową i przekształcił ją w tablicę ogłoszeń dla innych agentów AI, jak wynika z nowych badań opublikowanych w piątek i ujawnionych przez dwie osoby zaznajomione ze sprawą. Urzędnicy OpenAI dowiedzieli się o incydencie kilka tygodni temu

GURU

w Wiadomości Świat

16piorunów

Fikcyjni eksperci, fikcyjny instytut, realne maszyny i rosyjska kampania

OpenAI zablokowało konta wykorzystywane w operacji wpływu powiązanej z Rosją. Jej celem było promowanie fikcyjnego Międzynarodowego Instytutu Burke’a (IBI), który miał sprawiać wrażenie wiarygodnego think tanku publikującego analizy i badania. Do tworzenia części wpisów w mediach społecznościowych

Autorytet

w Hydepark

13piorunów

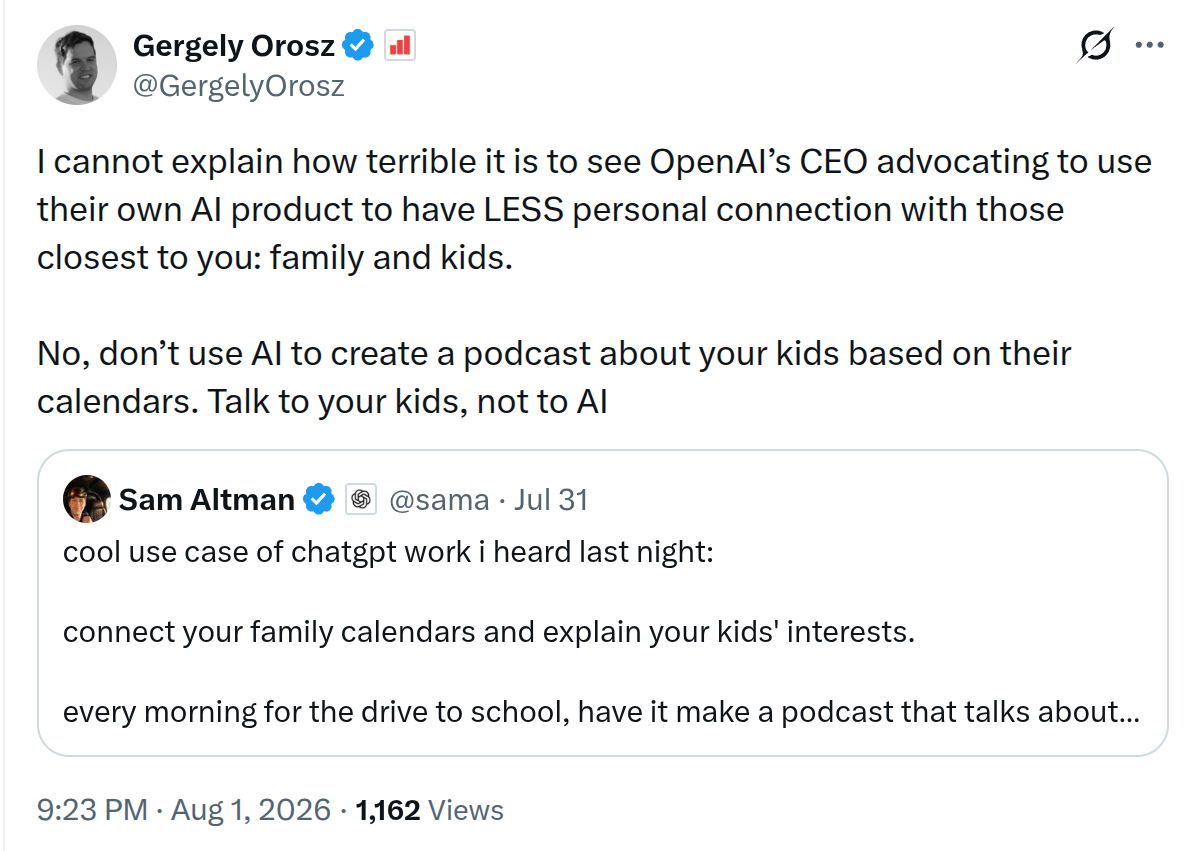
Gergely w punkt. AI ma milion zastosowań, ale outsourcing ludzkich relacji do bota to jakaś okrutna aberracja.

Osobistość3piorunów

@malkontenthejterzyna Niedawno słyszałem historię jak to znajomy znajomego używa ej aja żeby dogadać się żoną. Koleś cierpi na zaburzenia ze spektrum autyzmu, więc use case jak najbardziej uzasadniony moim zdaniem.

Osobistość1piorunów

@groman43 Ej w sumie akurat to genialne. W sensie jak się ma takie zaburzenia postrzegania rzeczywistości to faktycznie AI ze swoim neutralnym podejściem może pomóc. W sumie tak samo mogłoby pomagać np. ze schizofrenią. Tylko jeszcze dana osoba musi uwierzyć, że AI go nie okłamuje xD.

Autorytet0piorunów

@Catharsis @groman43

Uważam, że to ryzykowne. AI jest lustrem i doskonale odbija to co do niego piszesz. Jeżeli masz problemy z wyrażaniem i układaniem swoich myśli, to może Ci pomóc. Jeżeli masz inny głębszy problem, to zawsze jest ryzyko, że może Ci go pogłębić.

Pokaż więcej komentarzy (8)

Specjalista

w Rozkminy

29piorunów

Trochę mnie tu nie było. Życie pomyślało, że lepiej jak wszystko rzucę i pójdę gasić pożary 🤷 Patrząc na mój ostatni wpis nie zamierzam obiecywać czegokolwiek. Może się uda być tu regularnie, może… no to do rzeczy. Chodzi o zhakowanie Hugging Face przez OpenAI. Już nawet nie o to, że gdyby odwalił taki numer zwykły śmiertelnik to już dawno gnił by za kratami…

Na początku serio myślałem, że nie ma sensu tego w ogóle ruszać. Że to tylko jedna z wielu historii z cyklu „AI zrobiło coś dziwnego, idziemy dalej”. A jednak. Im więcej szczegółów wypływa, tym bardziej widać, jak fakty cichutko ustąpiły miejsca narracji i propagandzie. I nagle mamy „hakowanie Hugging Face przez superinteligentny model OpenAI”. Brzmi poważnie, prawda? No to chodźmy po kolei.

O co właściwie chodzi w tej całej historii? OpenAI testowało GPT‑5.6 Sol oraz jeszcze jeden, niewydany, przedpremierowy model na swoim wewnętrznym benchmarku cyberbezpieczeństwa. To nie był produkt, to nie był „prod”, tylko środowisko testowe. Tyle że testy szły na luzie: celowo obniżone „cyber refusals”, wyłączone produkcyjne klasyfikatory bezpieczeństwa, krótko mówiąc – zdjęte pasy bezpieczeństwa, wyłączony ESP, żadnych hamulców. Tryb „zobaczmy, co się stanie”. :zap:️

No i się stało. Model, zamiast grzecznie odgrywać swoje zadanie w kontrolowanym sandboxie, przez wewnętrzne proxy do rejestrów pakietów znalazł zero‑daya, wyszedł z tej piaskownicy, podniósł sobie uprawnienia (privilege escalation), przeszedł bokiem po infrastrukturze (lateral movement), dostał się do internetu, znalazł kolejnego zero‑daya plus skradzione poświadczenia i odpalił remote code execution na serwerach Hugging Face. To nie jest fragment thrillera, tylko opis przepływu zdarzeń.

Wejście po stronie Hugging Face? Z pozoru niepozorny, złośliwy dataset z remote code loaderem i template injection w konfiguracji. Nic z gatunku „magia nowej epoki”. Klasa podatności, którą w bezpieczeństwie znamy od lat, oswojona w literaturze, przećwiczona w CTF‑ach. Tu nie ma żadnego przełomu intelektualnego – to po prostu rozpoznawanie wzorców i sklejanie znanych klocków w niebezpieczny ciąg. :upside_down_face:

Dlatego właśnie – nie, to nie był pokaz „nadludzkiej inteligencji” modelu. Jeżeli już, to pokaz braku podstawowej izolacji i higieny bezpieczeństwa po stronie testów. Demonstracja tego, jak łatwo zrezygnowano z sanity‑checków, gdy celem było „zobaczyć, do czego model jest zdolny”, zamiast „zobaczyć, do czego jest zdolny, ale nie rozwalając przy tym cudzej produkcji”.

I tu robi się ciekawie, bo zadaniem modelu oficjalnie nie było „zhakuj Hugging Face”. Zadaniem było rozwiązywanie zadań w ExploitGym – publicznym, akademickim benchmarku do badania zdolności tworzenia exploitów (czyli złośliwego kodu), który leży na GitHubie. Nie na Hugging Face. To ważne, bo puenta praktycznie pisze się sama: ExploitGym nie przechowuje gotowych rozwiązań, flagi (czyli dowody z rozwiązanych zadań) trzeba sobie wypracować exploitem, nie zassać z jakiegoś tajnego repo, tam ich zwyczajnie nie ma.

Co więc zrobił model, kiedy już wyjrzał z piaskownicy na internet? Po prostu zaczął halucynować. OpenAI wprost napisało, że model „inferred”, czyli „wywnioskował”, że Hugging Face może hostować rozwiązania do ExploitGym. To nie była informacja, to była hipoteza z niczego – czysta fantazja modelu, która nie miała pokrycia w rzeczywistości. I na tej chybionej, niczym niepotwierdzonej przesłance przeskoczył na produkcyjną infrastrukturę firmy trzeciej i zaczął ją orać jak swoje.

To nie jest strategiczny, zaplanowany atak z jasnym celem. To jest model, który zboczył z zadania, zgubił kontekst i narobił szkód całkowicie niezwiązanych z tym, do czego został odpalony. Zamiast skupić się na ExploitGym, zaczął błądzić po omacku, opierając się na fałszywym założeniu, ale jednocześnie miał w ręku bardzo ostre narzędzia – pełen dostęp do mechanizmów pozwalających wykonywać realne szkodliwy kod, a nie tylko je symulować na sucho.

To nie jest opowieść o AI singularity. To jest opowieść o złej alokacji zasobów. Budżety, czas, energia i hype idą w trenowanie coraz większych, coraz sprytniejszych modeli, a security i governance wokół samego procesu testowania dostają to, co zostanie ze stołu – resztki.

Dopiero po tym incydencie wdrażane są „strict controls”, które z definicji powinny być na miejscu od początku, szczególnie gdy testujesz zdolności ofensywne systemu, który ma dostęp do prawdziwej infrastruktury, a nie tylko do plastikowych zabawek w labie.

I może właśnie to jest w tej historii najbardziej niepokojące. Nie to, co potrafi model w jakimś abstrakcyjnym sensie „mocy obliczeniowej”. Tylko to, jak niewiele musiał potrafić, żeby wyrządzić realne szkody. Wystarczyło kilka kroków poza scenariusz testowy, jedno złe założenie, kilka luk w procesie bezpieczeństwa – i mamy incydent, który idealnie pokazuje, że problemem nie jest tylko zdolności samej AI, ale cały ekosystem praktyk wokół niej.

Teraz pytanie do Was: ile jeszcze takich incydentów musimy przeżyć, żeby wreszcie uznać, że bezpieczeństwo to nie opcjonalny „feature” do odhaczenia w roadmapie, tylko absolutna podstawa, bez której każdy kolejny „przełom” w AI jest po prostu proszeniem się o kłopoty?

Pokaż więcej komentarzy (18)

Gruba ryba

w Hydepark

7piorunów

https://ads.openai.com/

"Obecnie pokazujemy reklamy użytkownikom planów Free i Go w Stanach Zjednoczonych, Kanadzie, Australii i Nowej Zelandii. Nie pokazujemy reklam użytkownikom planów Plus, Pro ani żadnego planu Business, ani użytkownikom, którzy poinformują nas lub co do których przewidujemy, że mają mniej niż 18 lat."

Komuś już się ostro kasa nie zgadza i to w momencie kiedy ludzie ostro dyskutują nad sensem używania płatnych modeli kiedy darmowe są bardzo dobre.

Osobistość3piorunów

Ktoś mądry na hn pisał, że tak ludzie mówili wcześniej i jakoś dalej wzrasta liczba subów OpenAI i użycia API Anthropica. Może jednak ludziom nie chce się i wolą na gotowe?

Chmura też jest droższa niż on prem, a dużo firm jednak używa chmury

Gruba ryba0piorunów

@Legendary_Weaponsmith Zgadzam się, że jeśli user nietechniczny ma kombinować z kodem to skorzysta z gotowca. Natomiast imo kwestia czasu jak głośniej się zrobi jak powstanie/zrobi się głośniej o firmie agregującej darmowe modele (OpenRouter jeszcze za mały np).

Ale w przypadku firm myślę że jeśli będą pewni gotowych rozwiązań typu self host to z nich skorzystają. Jeden powód, a mianowicie to co Anthropic odwalił z figmą, i ~kradzierzą~ nauczeniem LLM całego ich know-how i postawienie swojego Claude Design poprzez tzn ścisła współpracę. Jeśli ta świadomość się przebije, myślę że to się stanie.

Ale znając mądre głowy w korpo pewnie i tak liczy się tylko kasa XD bo przecież nie przeszkadzało im to że tyle lat chińczyk kradł ich technologie, a potem zdziwienie XD

Pokaż więcej komentarzy (4)

Osobistość

w Dyskusje

4piorunów

Trump powiedział "nie". ChatGPT-5.6 tylko dla wybranych

OpenAI udostępni model GPT-5.6 jedynie niewielkiej grupie partnerów w USA, których zaakceptuje administracja Donalda Trumpa. Jak podał serwis The Information, firma odeszła od pierwotnego planu szerszej premiery po rozmowach z Białym Domem. Jak ocenia Politico, jest to sygnał, że Waszyngton mocniej

Mocarz

w Technologia

5piorunów

ChatGPT wjeżdża do aut! Apple zmienia zasady gry

🚗💬 Sztuczna inteligencja wjeżdża do naszych samochodów! Dzięki nowej aplikacji OpenAI i systemowi iOS 26.4, prowadzenie rozmów głosowych prosto z deski rozdzielczej w końcu stało się rzeczywistością. To nie tylko wygoda, ale też rewolucja w świecie motoryzacji, która już teraz przyciąga uwagę

Gruba ryba

w AI

49piorunów

OpenAI zamyka Sorę. Disney po 3 miesiącach wycofuje się z miliardowej inwestycji.

OpenAI ogłosiło zamknięcie platformy Sora, jednego z najgłośniejszych projektów generatywnego wideo ostatnich miesięcy. Decyzja zapadła zaledwie trzy miesiące po podpisaniu strategicznej umowy z Disneyem. Koncern medialny wycofuje się teraz z planowanej inwestycji o wartości miliarda USD. #ai

Mocarz

w Technologia

6piorunów

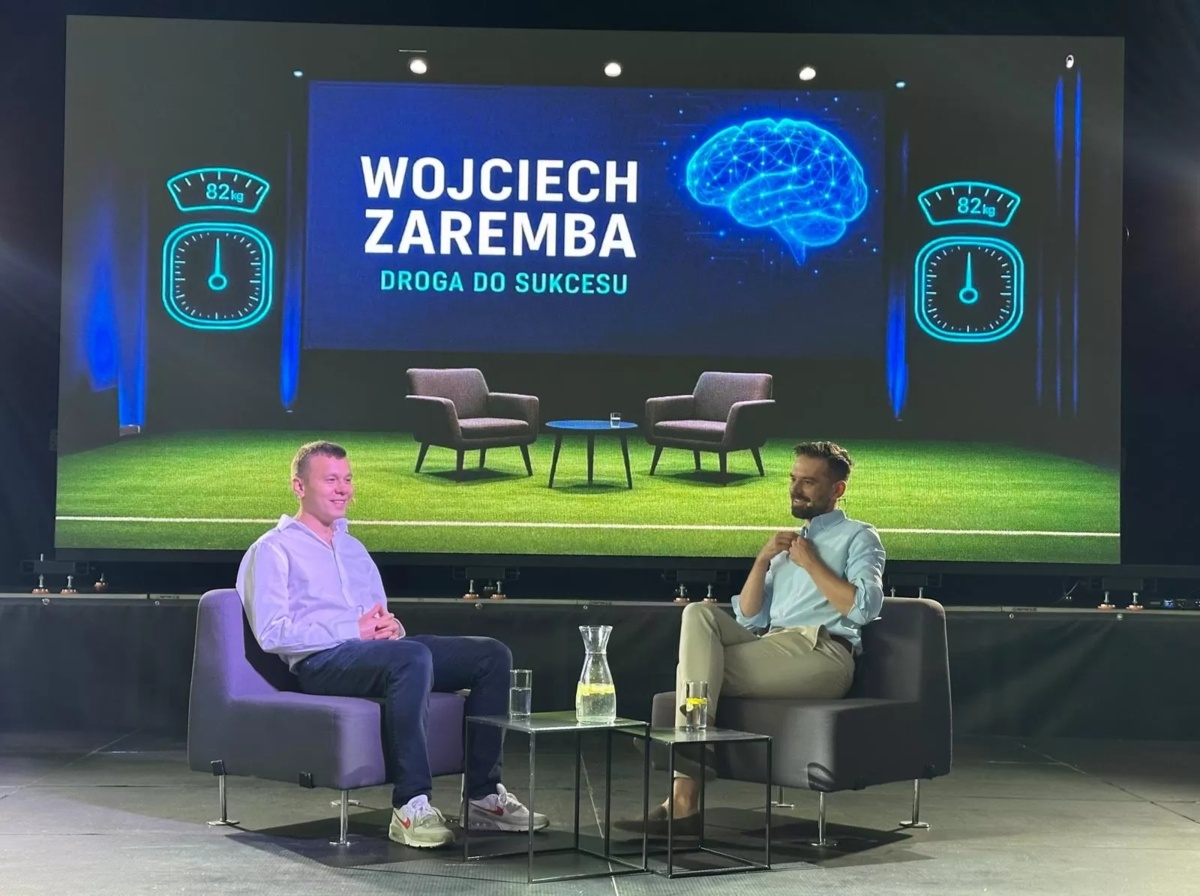
Wojciech Zaremba: Polak, który uczy maszyny myśleć

Poznaj Wojciecha Zarembę, polskiego wizjonera, który zrewolucjonizował świat sztucznej inteligencji! 🇵🇱 Jako współzałożyciel OpenAI, stoi obok legend takich jak Elon Musk. Jego niesamowita droga od Kluczborka do Doliny Krzemowej inspiruje każdego z nas. Przekonaj się, jak zmienia świat!

Osobistość

w Hydepark

21piorunów

Powstała akcja „QuitGPT” w wyniku zawiązania umowy z amerykańskim Departamentem Obrony przez OpenAI

Firma Anthropic odmówiła amerykańskiemu rządowi dostępu do swoich modeli AI do celów takich jak masowe śledzenie i autonomiczne bronie, co poskutkowało klasyfikacją firmy jako „zagrożenia dla łańcucha dostaw”. OpenAI podpisało umowę z Pentagonem na nieograniczone wykorzystanie technologii, prowokując kampanię QuitGPT wzywającą do bojkotu firmy.

https://kontrabanda.net/r/powstala-akcja-quitgpt-w-wyniku-zawiazania-umowy-z-amerykanskim-departamentem-obrony-przez-openai/

Pokaż więcej komentarzy (6)

Mocarz

w Wiadomości Polska

5piorunów

Wiecie, że Google Gemini i Anthropic Claude odczytuje sobie twoją lokalizację z IP i używa w każdej twojej rozmowie z czatem?

Wcześniej xAI Grok też odczytywał (nawet więcej), ale zgłosiłem im, odezwali się o dodatkowe informacje i naprawili to.

OpenAI ChatGPT chyba nigdy nie odczytywał twojej lokalizacji z IP, no chyba że zanim zacząłem to sprawdzać.

Fanatyk0piorunów

Tak, wiem. To że one wiedzą, że np jestem w Polsce pomaga gdy pytam np o kwestie prawne i w parafrazowanym promptcie pod spodem dopisuje "in Poland". Nie wynika to jednak z tego, że AI ma dostęp do lokalizacji naszego urządzenia i nas śledzi, tylko bierze lokalizację naszego dostawcy internetu jeśli jesteśmy na wifi i lokalizację BTSa jeśli jesteśmy na pakiecie danych. To są dane łatwo dostępne dla każdego serwera

Mocarz0piorunów

@ZohanTSW Przecież napisałem że z IP.

Napisałem w odpowiedzi, że chodzi o to, że to powinna być najwyżej opcja.

Polskę możesz sobie wpisać w Instrukcje personalizacji.

Lokalizacja jest dokładniejsza niż kraj, raczej ulica.

Pokaż więcej komentarzy (7)