tokensaveDebiutant
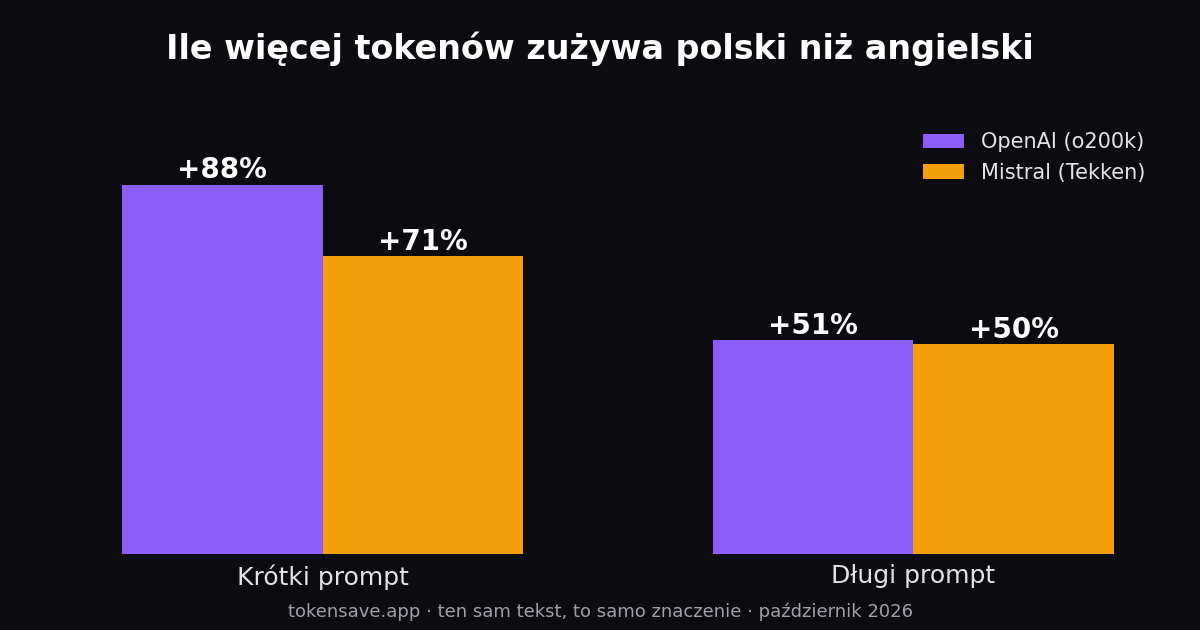
23piorunówZmierzyłem, ile tokenów „zjada” polski w modelach AI. Ten sam prompt o identycznym znaczeniu:
krótki (2 zdania): 34 tokeny po angielsku vs 64 po polsku (+88%*)
długi (~100 słów): 110 vs 166 (+51%*)
U Mistrala bardzo podobnie (+71% / +50%), więc „europejski” model nie pomaga. Winne są końcówki fleksyjne: „potwierdzenie” to dla tokenizera pot|wier|d|zenie, „zaproponuj” to zap|ro|pon|uj, a angielskie „invoice” czy „polite” to jeden token.
W praktyce w API płacimy za ten sam tekst nawet prawie 2× więcej, a w ChatGPT Plus / Claude Pro limit kończy się szybciej.
Trik: piszcie dłuższe instrukcje po angielsku i dodajcie na końcu „Reply in Polish”. Odpowiedź dalej przychodzi po polsku, a wejście jest krótsze o 31–41%.
Szczegóły i wykres: tokensave.app/pl/blog/ile-kosztuje-prompt-po-polsku
 CzokowokoGruba ryba0piorunów
U siebie po angielsku a u klienta wywalone póki unlimited tokeny XD
 ZohanTSWFanatyk0piorunów
Zauważyłem że nie zawsze potrafię dokładnie opisać co mam na myśli pisząc prompta po angielsku, szczególnie jeśli temat jest zawiły i sam mam braki w wiedzy, bo jestem na początku procesu. Czasami pomylę czas i to kompletnie zmienia sens zdania, które napisałem (i nie mówię o present simple tylko tych zawiłych czasach które nie mają odpowiedników w j polskim a w szkołach najmniej się o nich mówi). No i wreszcie pisanie prompta powinno być dość szybkie, a nie że siedzisz i się zastanawiasz przez 5 minut jak to zredagować (od tego jest AI przecież xd). Z tego powodu i tak piszę prompty po polsku, przynajmniej dopóki nie osiągnę biegłości w j angielskim bliskiej j polskiego :p

 eloyardFanatyk
 NiebieskiSzpadelNihilizmuLider
 O.oZawodowiec
 MarsjaminSum

 nbzwdsdzbcpsGURU

 KattaKTytan


 michal-g-1Fenomen

 entropy_GURU

 dziad_saksonskiOsobistość




 209poAutorytet
 szatkus-7Osobistość